인천국제공항공사, 9월 8일 ‘2026 세계항공컨퍼런스’ 개최… 공항 인프라 AI 대전환 예고
by
2026년 8월 31일
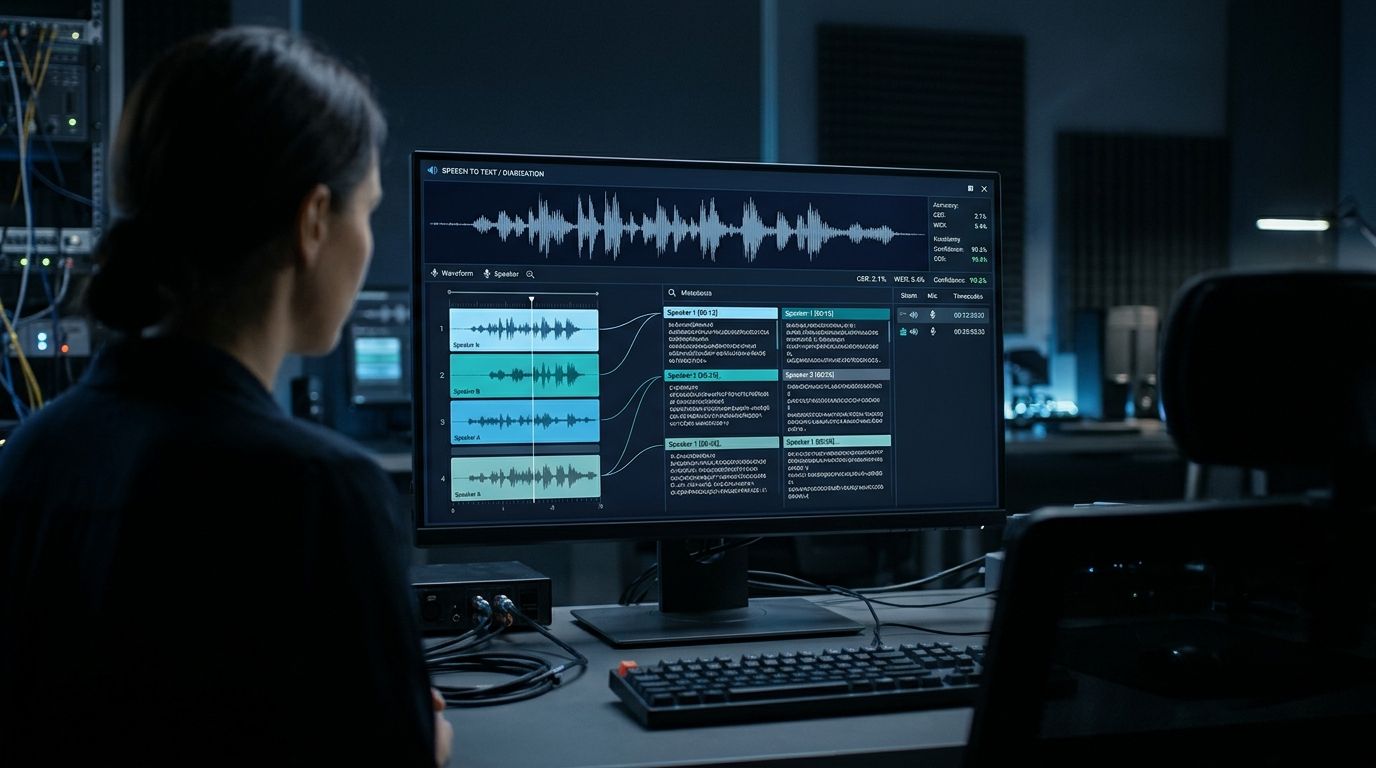
미국 반도체 기업 엔비디아(NVIDIA)가 40개 언어의 음성을 텍스트로 변환하고 화자를 구분할 수 있는 새로운 인공지능(AI) 모델을 공개했다. 음성 인식과 번역, 발화자 식별 기능을 하나의 모델에 통합해 기업과 개발자의 음성 AI 활용 범위를 확대한다는 계획이다.
엔비디아는 28일 '네모트론 3.5 트랜스크라이브(Nemotron 3.5 Transcribe)'를 공개하고 모델의 가중치와 기술 자료를 제공한다고 밝혔다. 해당 모델은 사전에 녹음된 음성 데이터를 처리하며, 이용자의 요청에 따라 다양한 형태의 전사 결과를 생성할 수 있도록 설계됐다.
음성 전사는 사람의 말을 문자로 변환하는 기술이다. 기존 음성 인식 서비스는 음성을 그대로 받아쓰는 기능을 중심으로 발전해 왔지만, 실제 업무에서는 화자를 구분하거나 구어체 표현을 문서에 적합하게 정리하는 등 추가적인 처리가 필요한 경우가 많다.
네모트론 3.5 트랜스크라이브는 이러한 작업을 하나의 모델에서 수행하도록 설계됐다. 개발자는 자연어 명령을 통해 녹음 내용을 그대로 문자화하거나 문서에 적합한 형태로 정리하고, 발언자를 구분한 결과를 생성하도록 요청할 수 있다.
지원 언어는 한국어를 포함한 총 40개다. 최대 1시간 분량의 녹음 파일을 처리할 수 있으며, 31개 언어와 영어 간 음성 번역도 지원한다. 여러 사람이 참여한 회의나 대화에서 발언자를 구분하고, 필요한 경우 단어별 발화 시점도 표시할 수 있다.
전문 용어를 처리하는 기능도 강화했다. 개발자가 예상되는 기업명이나 제품명, 전문 용어 등을 미리 제공하면 모델이 해당 정보를 참고해 음성 내용을 문자로 변환하는 방식이다. 의료와 금융, 고객 상담 등 특정 분야의 용어가 반복적으로 사용되는 업무에 활용할 수 있다.
엔비디아는 자체 성능 평가에서 기존 공개 가중치 음성 인식 모델과 비교해 높은 정확도를 기록했다고 밝혔다. 회사가 공개한 기술 보고서에 따르면 영어와 다국어 음성 인식 평가에서 각각 평균 4.71%와 4.62%의 단어 오류율을 기록했다.
단어 오류율은 음성을 문자로 변환하는 과정에서 단어가 잘못 인식되거나 누락되는 정도를 나타내는 지표다. 일반적으로 수치가 낮을수록 원본 음성에 가까운 전사 결과를 의미한다. 다만 실제 성능은 녹음 환경과 언어, 전문 용어의 사용 여부 등에 따라 달라질 수 있다.
엔비디아는 모델 개발에 필요한 가중치를 공개해 개발자들이 자체 환경에 맞게 활용할 수 있도록 했다. 클라우드 서버뿐 아니라 개인용 컴퓨팅 장비에서도 모델을 실행할 수 있도록 다양한 최적화 버전을 제공할 계획이다.
함께 공개한 음성 데이터셋 '그래너리 2(Granary v2)'도 음성 AI 개발에 활용할 수 있다. 개발자는 해당 자료와 엔비디아의 음성 AI 개발 도구를 이용해 특정 언어나 산업 분야에 적합한 모델을 구축할 수 있다.
다만 이번 모델은 사전에 녹음된 음성을 처리하는 방식으로, 실시간 대화 내용을 즉시 받아쓰는 기능과는 구별된다. 엔비디아는 향후 다양한 하드웨어 환경에서 사용할 수 있도록 모델의 실행 효율성과 접근성을 확대한다는 방침이다.
박태민/taemin2347@newsdot.net
※ 참고자료
*NVIDIA, "NVIDIA Nemotron 3.5 Transcribe: Intelligent Transcription with a Speech LLM", 2026년 10월 28일 참조.
*TechCrunch, "Voice AI in vogue: Nvidia releases new open transcription model", 2026년 10월 28일 참조.